中经记者 谭伦 上海报道
近日,围绕“赋能AI计算的未来”,Arm推出多项面向智能体时代的新产品与生态计划,覆盖云、边缘和物理AI三大领域。其中,Arm Neoverse CSS N4面向新一代AI基础设施,Arm CSS for Mobile 2进一步强化端侧智能体与AI原生图形能力,Arm还把Total Design生态扩展至物理AI,并推出机器人能力分级框架。此外,Arm AI Portal上线,连接其超过2200万开发者生态。
这些动作显示,对于即将到来的AI智能体时代,这家巨头有了全新的思考。作为一家过去以CPU架构IP为核心的供应商,Arm正进一步向覆盖IP、计算子系统、芯片、软件生态的计算平台演进,并将这一平台延伸到云、边缘和物理世界。
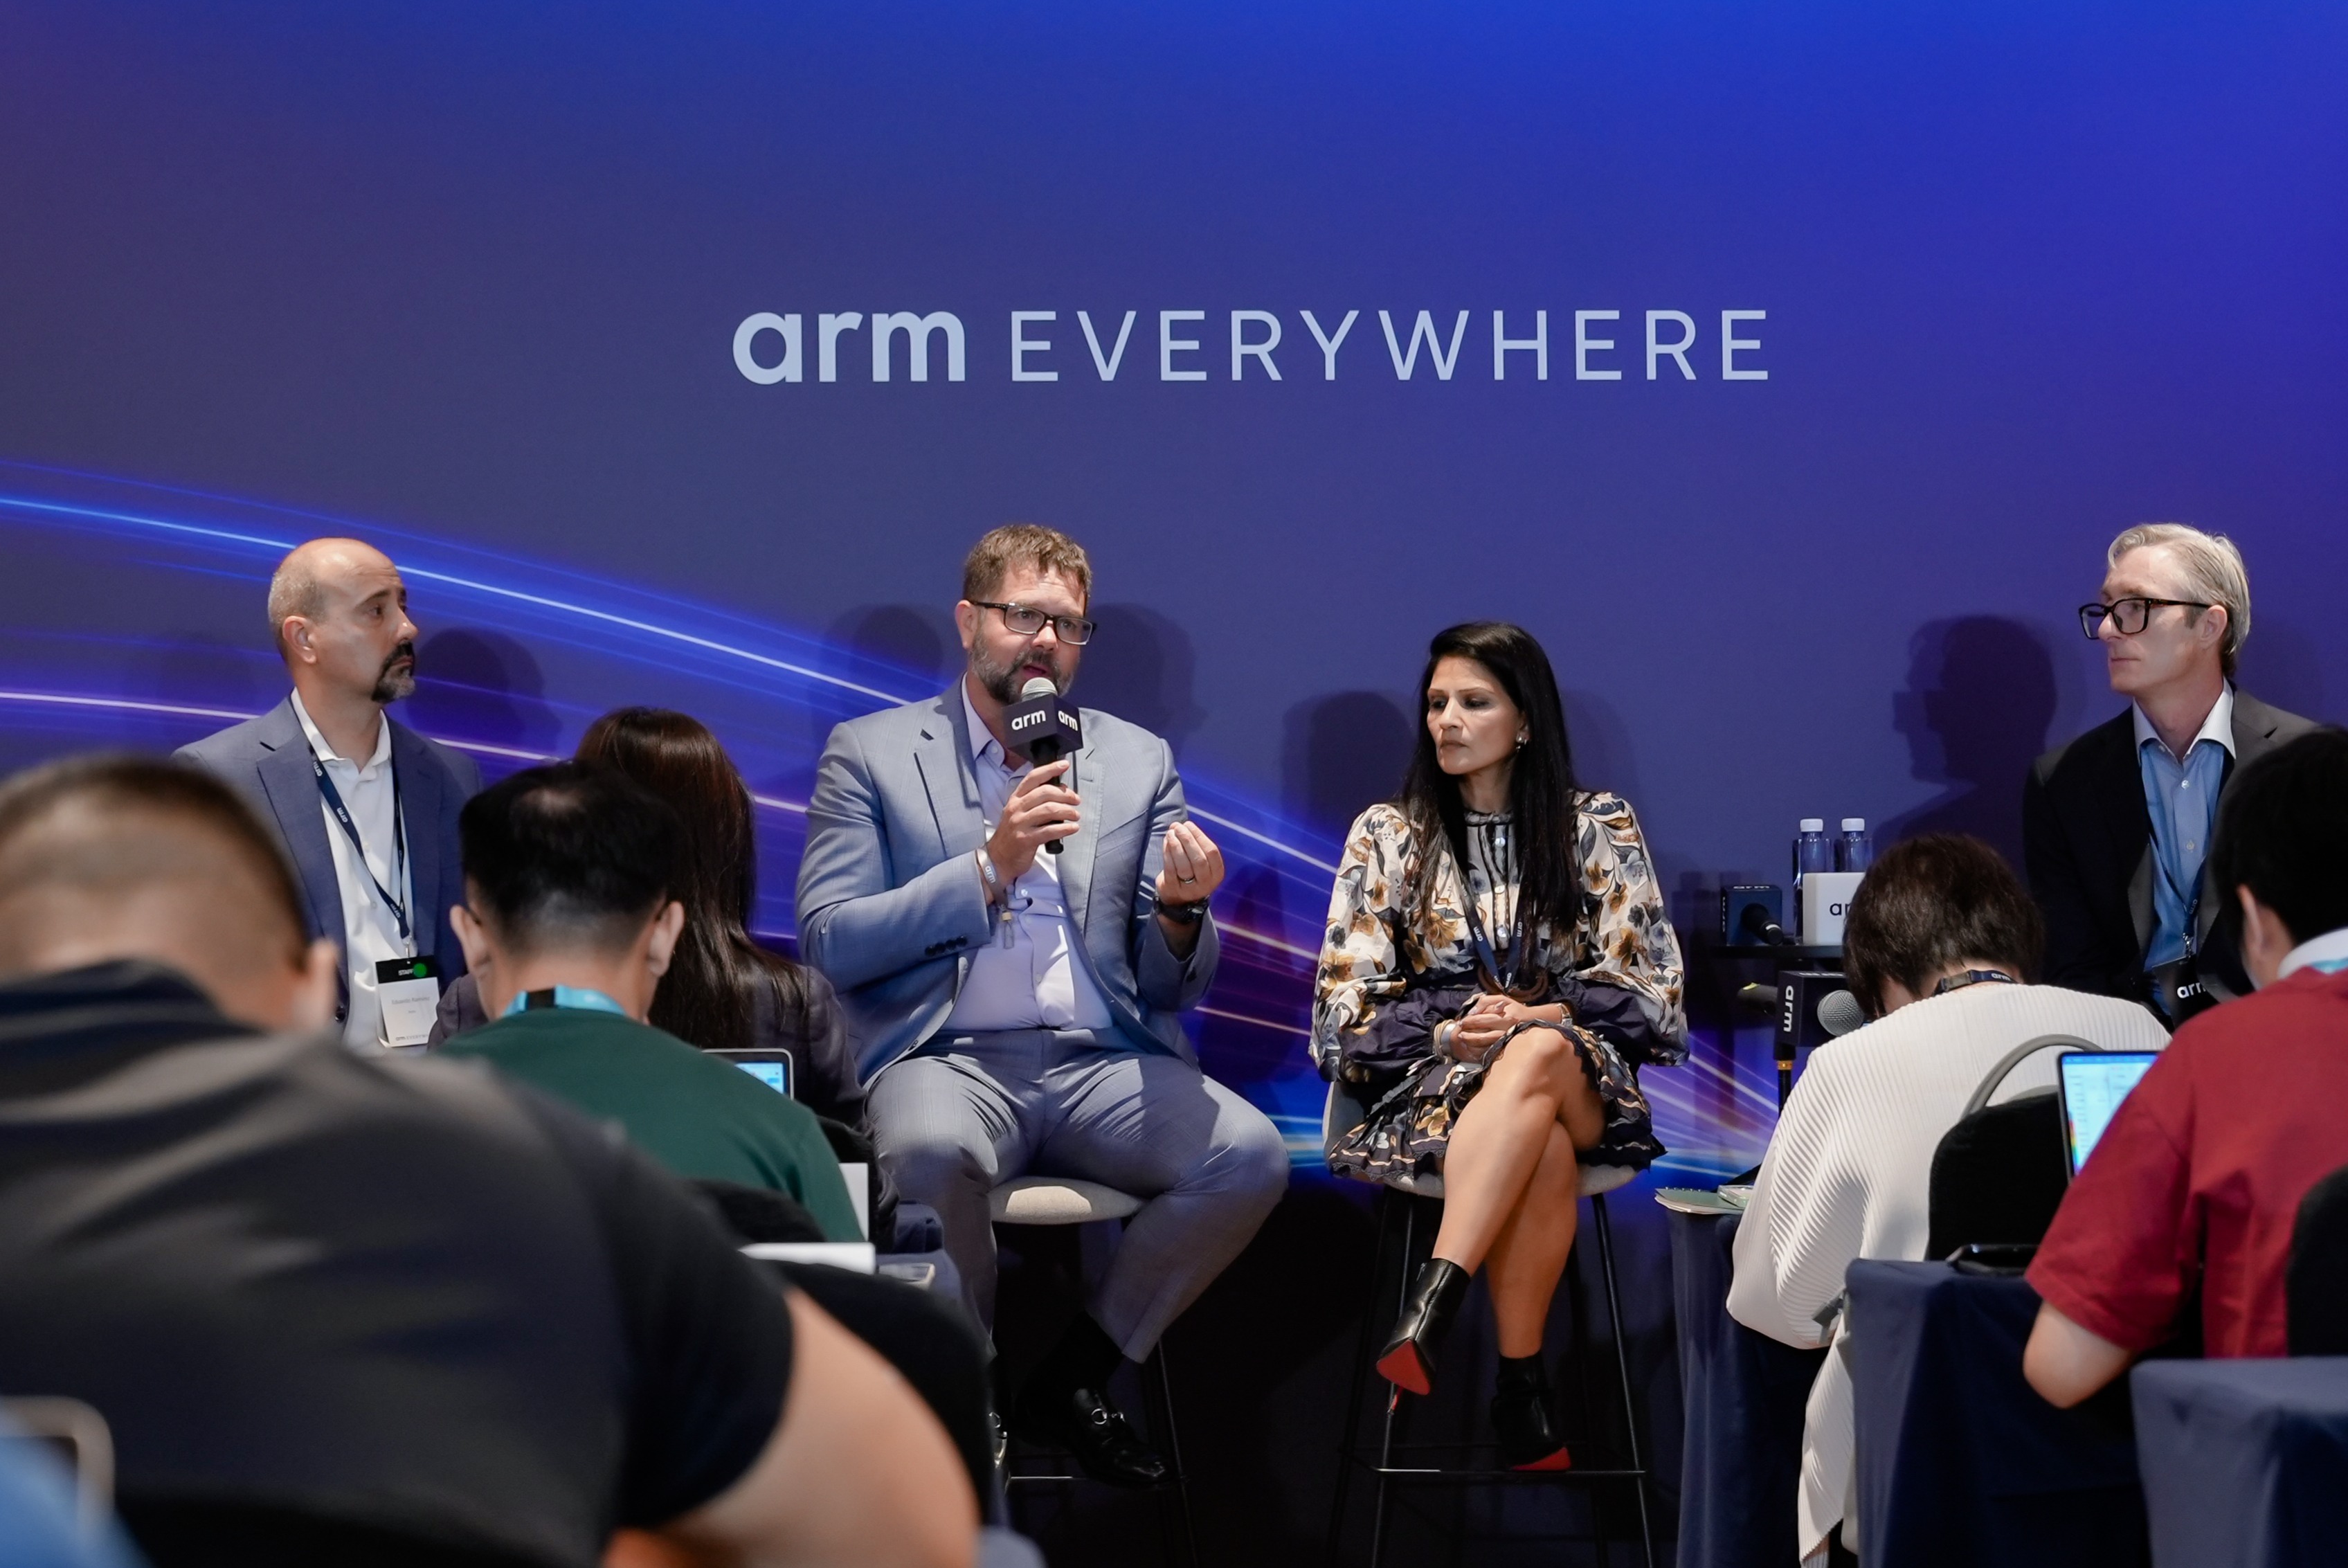
今年以来,智能体AI正在加速从概念走向实际应用。Gartner预计,2026年全球AI支出将达到2.59万亿美元,同比增长47%;其中AI基础设施占比超过一半,AI优化服务器未来五年将成为最大的细分市场。与此同时,2026年全球AI推理支出预计达到233亿美元,首次超过训练支出。
CPU重新回归AI竞争焦点
两年前生成式AI兴起时,算力产业的主角主要是GPU和各类AI加速器。用户发出提示词,模型进行推理,再返回文本、图片或代码,计算任务相对集中在模型本身。
但在Arm首席营销官Ami Badani看来,智能体AI改变了这一工作模式。“智能体需要调用工具、访问数据库、检索信息、调度其他智能体,处理日趋复杂的工作流。”大会期间,Ami Badani向记者表示,上述大量调度任务目前都由CPU完成。
这也是Arm今年3月推出Arm AGI CPU的逻辑起点。
在产业层面,这一变化正在得到市场数据的印证。SemiAnalysis发布研报显示,在现代智能体编程工作负载中,42%的执行时间用于CPU驱动的工具调用。Gartner今年6月发布的研究也直接指出,智能体AI正在把CPU重新带回聚光灯下。
Arm此次进一步发布Neoverse CSS N4,正是希望抓住这一结构变化。该产品是Arm目前可配置性最高的Neoverse计算子系统,可针对CPU核心数量、缓存、内存、I/O以及加速器连接方式进行配置,每个芯片可配置8至128个CPU核心,并针对智能体AI数据中心提升性能、能效和内存带宽。
更值得注意的是,Arm已不再满足于单纯提供IP。
Ami Badani将Arm当前的产品路径概括为三个层次:客户可以选择Arm IP,也可以选择CSS计算子系统,如今还可以直接采用生产就绪的Arm AGI CPU。“客户有三种不同的起点可供选择:IP、CSS,以及Arm AGI CPU。”Ami Badani指出。
这实际上意味着,Arm商业模式正在发生变化:从“授权CPU架构”,向“提供完整计算平台”延伸。
Arm今年3月推出的AGI CPU已经成为这一战略最直接的落点。Arm官方表示,其单机架性能较x86平台提升超过2倍,每GW AI数据中心基础设施最高可节约100亿美元资本开支;在其2027财年第一季度财报中,Arm披露已经获得超过20亿美元的客户需求。
而在此次大会上,Arm进一步宣布,其AGI CPU正获得云厂商、OEM和软件伙伴的推进。对此,Arm云AI业务拓展副总裁Eddie Ramirez透露,Arm正在与火山引擎合作,将Arm AGI CPU引入其数据中心,以支持下一代AI服务。
更重要的是,Arm并不认为自研芯片会侵蚀原有IP授权业务。“我们始终将这一举措视为市场空间的延展,而并非与现有云服务商客户之间的竞争。”Ami Badani表示。
从产业链看,这种“IP+CSS+芯片”的组合,也使Arm能够同时覆盖不同类型的客户:大型云厂商、芯片设计公司可以继续基于Arm IP进行差异化设计;希望缩短研发周期的客户可以直接采用CSS;而希望快速部署生产级计算平台的客户,则可以使用Arm设计的芯片。
AI计算的“战场”正变得更分散
如果说云端业务代表Arm对AI基础设施的新进攻,那么边缘AI则是其原有优势被重新激活。
Ami Badani认为,Token成本、安全性以及响应延迟,正在推动智能体从云端向边缘分布式部署。“越来越多的智能体将迁移至边缘本地运行。”她表示。
这意味着,未来AI并不会简单地形成“云端越来越强、终端越来越弱”的单向结构,而可能形成云端、边缘协同计算的体系。高复杂度模型依然在云端运行,而大量涉及实时交互、个人数据和持续任务的工作,则越来越多在本地完成。
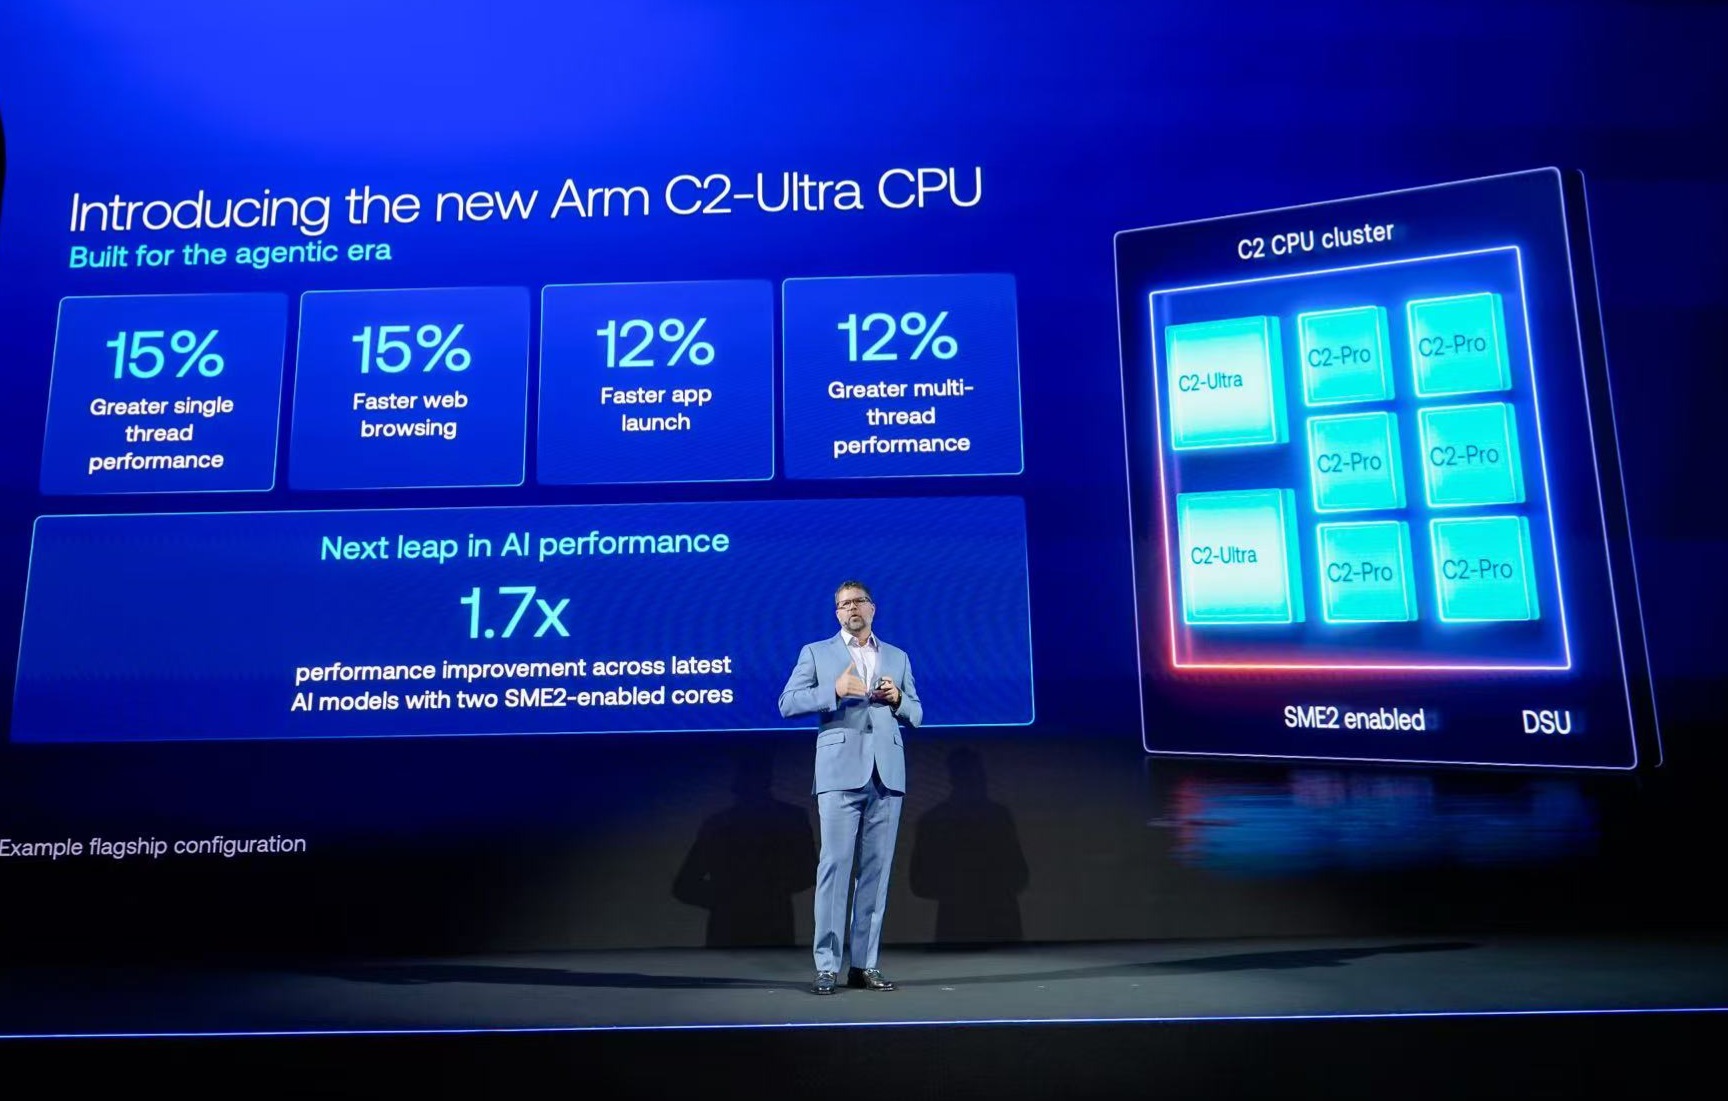
Arm此次推出CSS for Mobile 2,正是针对这一变化。官方参数显示,该平台集成C2 CPU集群、Mali G2-Ultra NX GPU和系统级互连,并引入SME2和专用神经网络加速器,以支持持续运行的端侧智能体和AI原生图形。Arm披露,在特定测试条件下,与上一代C1-Ultra相比,C2-Ultra可带来最高1.7倍AI性能提升,并通过神经图形实现最高4倍帧率提升。
Arm边缘AI执行副总裁Chris Bergey强调,Mali G2-Ultra NX并不是一个单一固定配置的产品,客户可以根据性能目标自主决定着色器和神经引擎的配置。例如在16个着色器的配置中,可以只为其中8个配置神经网络引擎。
这些部署的目的在于,将“异构计算”进一步系统化。未来的智能手机、PC、可穿戴设备乃至更多边缘终端,需要的并不是单一意义上的“AI芯片”,而是CPU、GPU、NPU及系统软件之间的协同。智能体不仅需要推理,还要理解上下文、调用应用、完成任务,这使得CPU的调度能力、系统级数据传输效率和持续能效都变得更加重要。
Counterpoint Research近期发布的研报也指出,生成式AI、异构计算和半导体复杂度正在同时重塑智能手机、PC、边缘设备和云基础设施,AI手机、Windows on Arm以及边缘AI均将成为计算架构变化的重要方向。
因此,从手机到PC,再到智能眼镜等新终端,Arm实际押注的是同一个趋势:未来越来越多AI不需要等待云端响应,而是在设备本地持续运行。而这,恰恰是Arm“每瓦性能”优势最容易转化为商业价值的地方。
AI竞争将延伸至物理世界
相比云端CPU和移动端AI,此次Arm释放的另一大信号,是开始更明确地将“物理AI”提升到战略层面。
9月8日,Arm宣布将Arm全面设计生态项目(Arm Total Design)进一步扩展至物理AI,已经吸引超过80家企业参与,覆盖云、芯片、软件、机器人和工业等多个环节;与此同时,Arm发布机器人能力分级框架,希望为机器人行业提供统一的能力描述语言。
Arm物理AI业务拓展副总裁Dermot O'Driscoll直言,当前机器人行业仍处于早期阶段。“整个生态系统在架构、标准和能力方面依然较为分散。”在他看来,Arm此时参与物理AI,并不只是卖一套芯片或IP,而是试图把模型、软件、数据、计算以及机器人企业连接起来。“我们的总体目标,是帮助产业缩短产品上市时间并加快部署,其中包括对软件栈、数据集、数据模型和大模型的优化。”Dermot透露。
这一战略,与中国机器人市场的现实发展高度契合。国际机器人联合会(IFR)数据显示,2024年中国工业机器人安装量达到29.5万台,占全球总量的54%,工业机器人保有量已经超过200万台,均居全球首位。也就是说,中国不仅拥有全球最大的机器人装机市场,也正在成为AI与机器人融合的重要试验场。
这也成为Arm高度看重中国市场的原因。Ami Badani表示,中国在AI、智能终端、汽车和机器人等领域扮演越来越重要的角色,Arm会根据市场发展和合作伙伴需求,持续演进自身的产品与服务。
更值得关注的是,Arm并没有试图通过自己的机器人平台“统一”这个行业,而是提出一个更轻量化的框架。
Dermot O'Driscoll表示,机器人能力分级框架“并非旨在取代现有标准”,而是希望聚合产业链参与者,“为机器人平台能力建立一套统一的思考和描述方式”。换言之,Arm试图解决的并不是“谁制定标准”的问题,而是机器人产业在规模化阶段面临的一个现实难题:不同企业对机器人能力、软硬件接口和部署要求缺乏统一语言。
从产业角度看,这可能恰恰是Arm更擅长的事情。过去几十年,Arm依靠统一架构和庞大的开发者生态,把不同终端连接到了同一套计算体系中。如今进入物理AI阶段,Arm试图复制类似思路,把原本分散的机器人企业、芯片公司、软件开发者、云服务商和工业客户连接起来。
而这些变化,也将Arm对AI时代的思考,诠释得更为清晰:在智能体时代,AI基础设施的竞争,可能正从单纯数据中心算力,进一步走向云、边缘、终端和物理设备。而对于拥有广泛CPU架构基础和生态的Arm而言,这或许正是其希望抓住的下一轮产业红利。
(编辑:张靖超 审核:李正豪 校对:颜京宁)
-
-
 2026-09-24 陈佳岚
-